88比12!在攻克癌症这件事上,垂类AI比国际主流通用大模型和人类医生都在行?
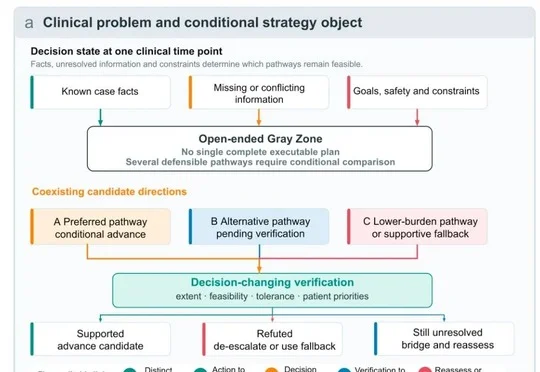
88比12!在攻克癌症这件事上,垂类AI比国际主流通用大模型和人类医生都在行?未来医生医疗大模型MedGPT在40例真实复杂肺癌病例盲评中以88:12战胜250名三甲医生,综合评分96.22领先GPT-5.4 Direct、Claude Opus 4.7 Direct和Gemini 3.1 Pro Direct,并使医生辅助下方案得分提高24.1%。
搜索
未来医生医疗大模型MedGPT在40例真实复杂肺癌病例盲评中以88:12战胜250名三甲医生,综合评分96.22领先GPT-5.4 Direct、Claude Opus 4.7 Direct和Gemini 3.1 Pro Direct,并使医生辅助下方案得分提高24.1%。
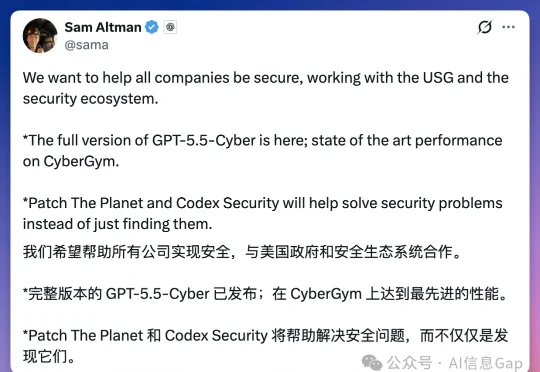
就在刚刚,OpenAI 直接放出了满血版 GPT-5.5-Cyber。CyberGym 安全评测排行榜,GPT-5.5-Cyber 得分 85.6%,单模型最高分。Claude Mythos 5 第二,83.8%。Claude Opus 4.7 排末尾,73.1%。
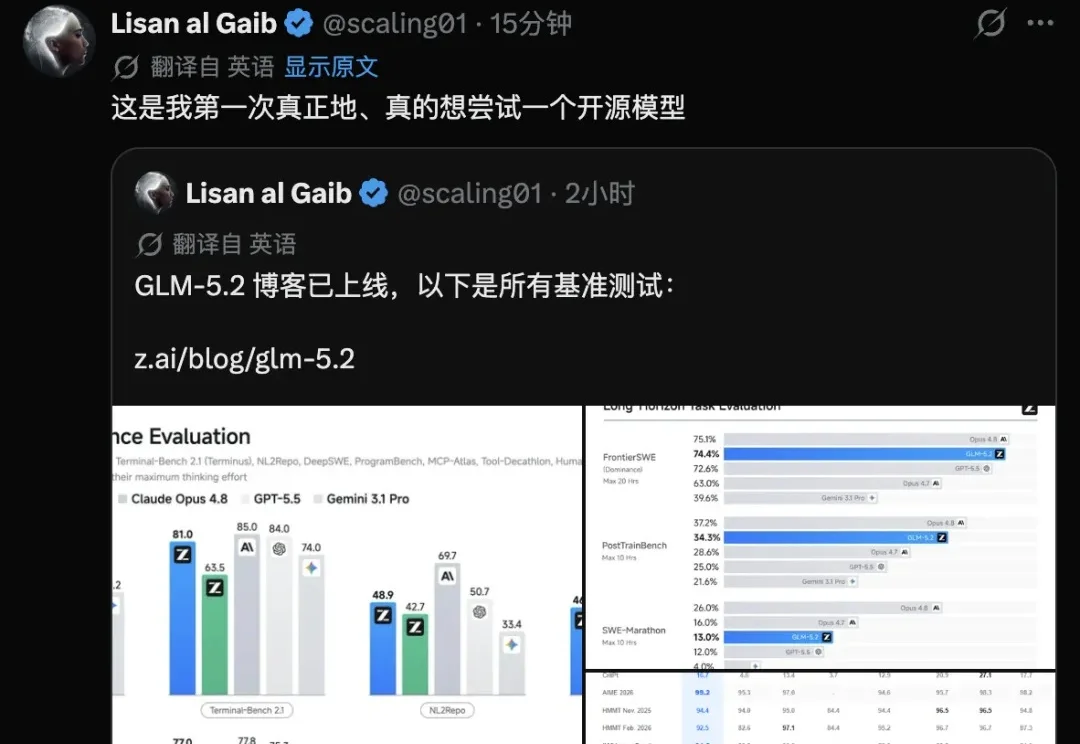
GLM-5.2 正式发布,震撼全网,主打长程任务能力,配合 1M token 上下文窗口,且完全开源(MIT 协议)。在相近的 token 消耗下,GLM-5.2 的能力大致介于 Opus 4.7 和 Opus 4.8 之间,参数仅为753B。
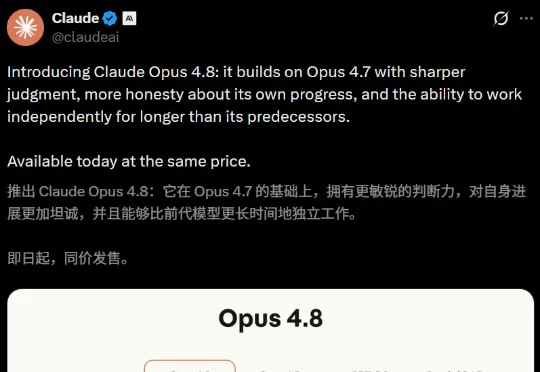
Anthropic最强通用模型Claude Opus 4.8正式发布,新模型基准测试全面超越Gemini 3.1 Pro、Opus 4.7,仅一项逊色于GPT-5.5,但其标准模式价格不变,快速模式价格仅为Opus 4.7的1/3。与此同时,Anthropic还官宣一笔650亿美元(约合人民币4406.94亿元)H轮巨额融资,投后估值冲上9650亿美元(约合人民币6.54万亿元)
Opus 4.7发布刚43天,Opus 4.8就来了!编程实力暴增,全面霸榜。Claude Code一口气放出上百个agent并行干活,一个人11天就能重写75万行代码、99.8%测试通过。更狠的Claude Mythos,几周后就来。
超越 GPT-5.5、Gemini 3.5 Flash、DeepSeek V4 Pro,阿里的最新旗舰模型 Qwen3.7 Max 在编程竞技榜拿下第二名,仅次于 Claude Opus 4.7。除了真实场景的用户选择,在传统的大模型固定评测榜单上,像是终端能力 Terminal Bench、编程能力 SWE Bench 等,Qwen3.7 Max 的表现也是拿下了国产模型的冠军。
「以 1/10 的成本,性能几乎追平 Claude Opus 4.7 这个级别的模型。」
上次给大家写了《Codex教程》之后,评论区里陆陆续续冒出来好多问题。问的最多的,是土区订阅 ChatGPT Plus 的事。既然是已经存在的定价差异,还有那么多人不知道,那就写,写清楚,手把手教到会为止。
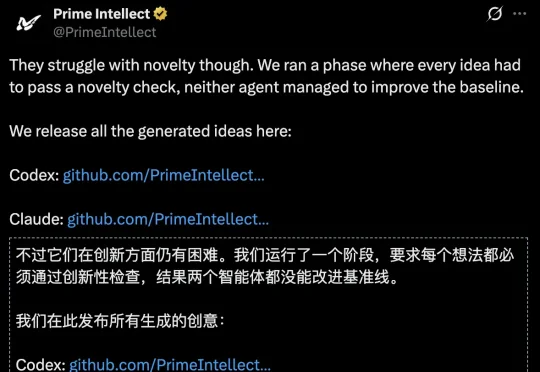
Prime Intellect把Opus 4.7和GPT 5.5关进H200集群,不给人类指导,跑了1万次实验。结果:AI第一次在科研竞赛中打破人类纪录。2930步,递归自改进的卢比孔河,被跨过了。
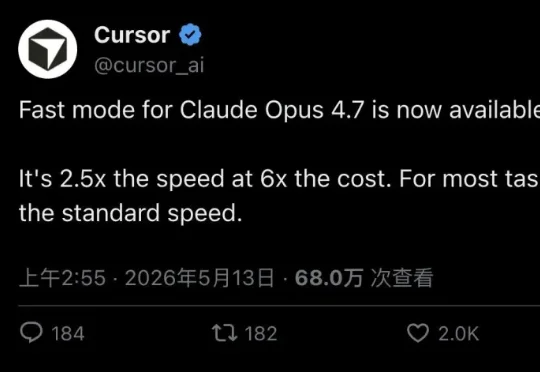
Cursor 正式接入 Claude Opus 4.7 Fast mode——同一个旗舰模型,拆出两个速度档。快 2.5 倍,贵 6 倍,输出价每百万 token 150 美元。最离谱的是,Cursor 官方在发布当天就建议:多数任务请用标准速度。